DeepSeek V4.1 FlashはDGX Spark互換機(GB10)1台でどこまで実務利用できるか:生成・長文入力・エージェント利用で見る三つの待ち時間
DeepSeek V4.1 Flashは、公開実装を用いることで、DGX Spark互換機(GB10)1台で動かせます。しかし、「1台で動く」ことと、すべての用途で快適に使えることは同じではありません。
本記事では、短い応答、長文の一回処理、反復エージェント処理という三つの処理パターンに分けて、待ち時間の違いを確認します。
いずれも本検証環境での値で、条件が異なる環境との単純比較には使えません。
結論:三つの処理パターンに分けて待ち時間を見る
DGX Spark互換機(GB10)1台でこの規模のモデルが動くことと、どの業務でも待ち時間なく使えることは、別の問題です。本検証では、処理パターンを次の三つに分けて待ち時間を見ると、違いを整理しやすくなりました。
- 短い応答:回答開始前の入力処理と、回答を生成する時間を分けて確認しました。
- 長文の一回処理:回答開始前に長い入力を処理する時間を確認しました。
- 反復エージェント処理:ツール利用を含む複数回のやり取りで、入力長と作業全体の時間を確認しました。
約6万token(文章を細かく分けた処理単位)の長文を一回だけ処理する場合、本検証では回答開始前に約14.8分かかりました。長文を繰り返し利用する場合でも回答開始前の入力処理は発生しますが、既に処理した共通部分を再利用できる仕組みがある場合は、毎回同じ待ち時間になるとは限りません。なお、本検証で約6万tokenを測定したのは1回です。短い応答、長文の一回処理、反復エージェント処理では、確認すべき待ち時間が異なります。
今回動かしたのはどの実装か
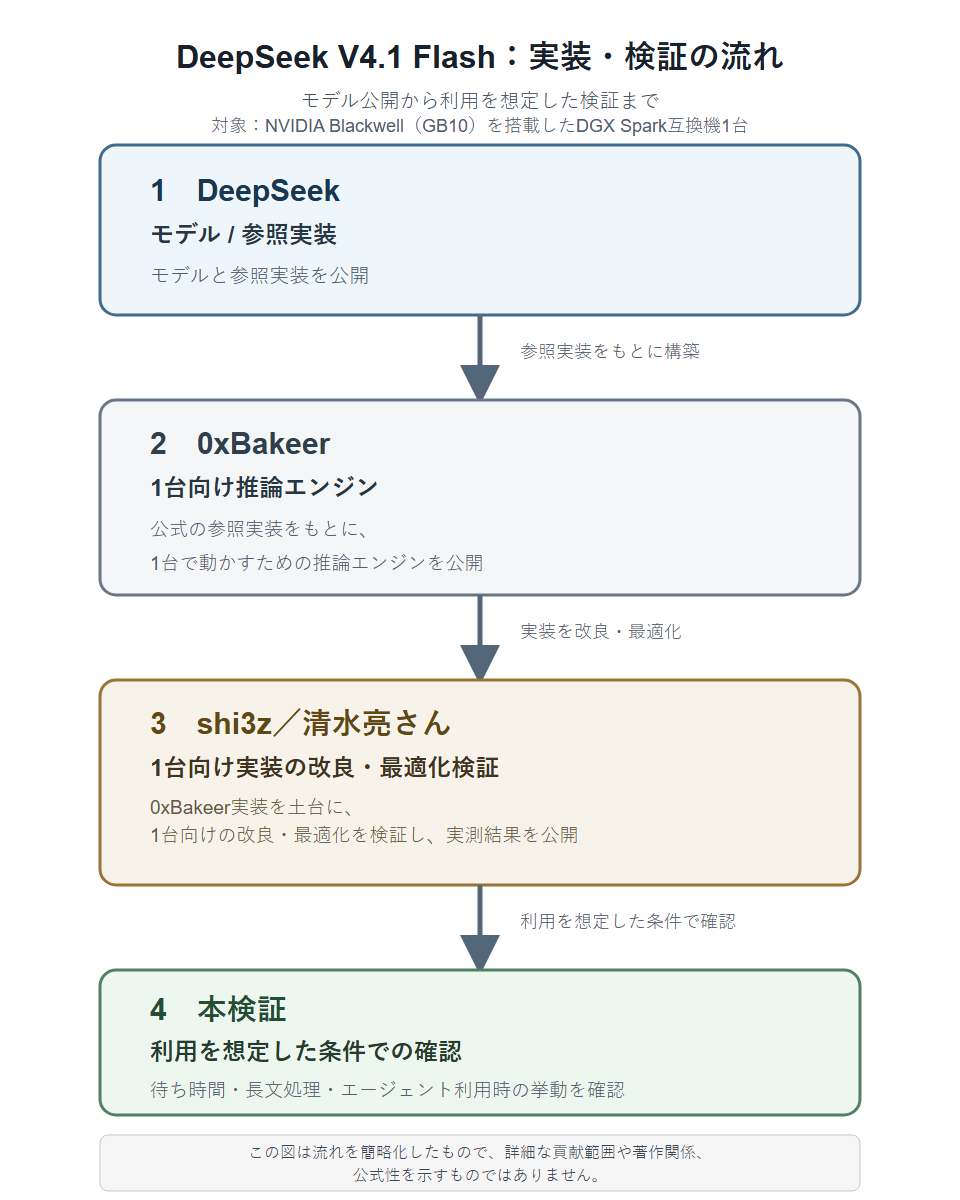
DeepSeekはモデルと参照実装を公開しています。0xBakeerは、その参照実装をもとに、DGX Spark互換機(GB10)1台向けの推論エンジン(モデルを実際に動かすソフトウェア)を公開しました。shi3z(清水亮さん)は、0xBakeer実装を基に、DGX Spark互換機(GB10)1台向けの改良・最適化の検討と実測を行い、その検証結果を公開しています。本検証ではshi3zの公開実装を利用し、主に起動時の設定を変えて、待ち時間、長文処理、エージェント利用時の挙動を確認しました。
この規模のモデルをDGX Spark互換機(GB10)1台で実際に試せる形と、改良・最適化の実測結果が公開されていることで、本記事のように、実務利用を想定した検証が可能になりました。
数値を読むための前提
以下は、長文の一回処理と反復エージェント処理で主に用いた設定です。短い応答の17.26 token/秒だけは、文脈長の上限を32,768 tokenにして測定しています。
| 項目 | 今回の値 | 読み方 |
|---|---|---|
| 検証環境 | DGX Spark互換機(GB10)1台 | 1台構成での観測 |
| 文脈長の上限設定 | 65,536 token | 入力・出力などを含む文脈長の上限として設定 |
| 長文を小分けに処理する単位 | 1,536 token | 長い入力をこの単位に分けて処理 |
ここからは、短い応答、長文の一回処理、反復エージェント処理の順に結果を見ます。
短い応答:生成処理は17.26 token/秒
短い日本語生成として、「日本の四季の特徴を、3文で簡潔に説明してください。」と指示する測定を行いました。同じ短い入力を一度実行した後、回答を生成している間に、追加の重み(モデルが学習で得た計算用の数値データ)の読み込みが発生しなかった状態では、生成処理の中央値は17.26 token/秒でした。
この短文測定では、回答の生成に約6.1秒、回答開始前の入力処理に約2.5秒かかりました。後述の約6万tokenの長文測定では、回答開始前の入力処理だけで約14.8分かかりました。ただし、入力長も設定も異なるため、短文と長文の数値はそのまま比較できません。
約6万tokenの長文では、回答開始前に約14.8分待った
約6万tokenの長文から、文頭・中盤・末尾の3か所に置いた確認情報を、すべて取り出せるか確認しました。59,999 tokenでは3か所すべてが一致しましたが、回答を生成し始める前の入力処理に888.2秒、約14.8分かかりました。
ここでの「入力長」は、その測定で実際にモデルへ渡した入力token数です。65,536 tokenは入力・出力などを含めて扱う文脈長の上限設定で、各測定の入力長ではありません。表の59,999 tokenは、その測定で実際に投入した入力長です。ここでいうExpertは、モデル内部に多数ある計算部分のうち、入力に応じて選ばれて使われる部分です。
| 入力長 (token) |
確認情報の一致数 (文頭・中盤・末尾) |
回答開始前の 入力処理時間 |
入力処理速度 (token/秒) |
Expertの重みの読込量 (エンジン記録値) |
|---|---|---|---|---|
| 16,381 | 3/3 (3か所すべて一致) |
242.8秒 | 67.5 | 924.9 GB |
| 32,763 | 3/3 (3か所すべて一致) |
491.0秒 | 66.7 | 1,820.8 GB |
| 59,999 | 3/3 (3か所すべて一致) |
888.2秒 (約14.8分) |
67.5 | 3,232.2 GB |
59,999 tokenの長文を1回入力した処理全体は約890.8秒で、そのうち888.2秒が回答開始前の入力処理でした。この測定では、待ち時間の大半が回答開始前に発生していました。
数値の読み方:表の3行はいずれも、先の「数値を読むための前提」で示した65,536 token/チャンク1,536 tokenの設定で、各入力長を1回ずつ測定した結果です。「3/3」は一致した確認情報の箇所数で、試行回数ではありません。表の読込量は、1回の測定でExpertの重みをどれだけ読み込んだかを、推論エンジンが記録した値です。約6万tokenでは、この読み込みは主に回答開始前の入力処理中に発生しました。SSDの物理転送量そのものを測った値ではありません。
長文で待ち時間が増える背景:Expertの重みの読み込み
今回利用した推論実装では、モデル内部の多数の「Expert」のうち、よく使う一部のExpertの重みをメモリに保持し、それ以外は必要になったときにNVMe SSDから読み込みます。回答開始前の待ち時間が長くなる流れは、次のとおりです。
- よく使う一部のExpertの重みをメモリに保持します。
- 長い入力は一度に処理せず、複数の単位に小分けして処理します。
- 各単位を処理するとき、メモリにないExpertの重みが必要になると、NVMe SSDから読み込みます。
- 長い入力ほどこの読み込みの機会が増え、本検証では回答開始までの時間も長くなりました。
この小分けに処理する単位を、ここでは「チャンク」と呼びます。本検証では、チャンクを大きくすると一時的なメモリ使用のピークが高くなりました。小さくすると分割回数が増え、入力処理が長くなり、Expertの重みの読込量も増えました。
補足:本検証では2,048、1,536、1,024 tokenを比較し、その中間の1,536 tokenを今回の折衷値として採用しました。これは他の環境での最適値を示すものではありません。
SSDを使う推論環境でも、SSDに置くデータや、繰り返す入力の扱い方が異なれば、待ち時間の出方が同じとは限りません。今回のDeepSeekの測定値を、そのまま別の構成の待ち時間に当てはめることはできません。
エージェント利用では、応答を重ねると入力処理も増える
Clineは、指示に応じてファイルを読み取るなど、複数の手順を進められるコーディングエージェントです。Clineのようにツールを使いながら処理を続けるコーディングエージェントでは、前の処理結果を踏まえて次の応答へ進みます。本検証でも、やり取りを重ねると、次の応答でモデルが処理する入力が増える例を確認しました。入力が増えれば、回答を生成する前の入力処理も長くなり得ます。
今回採用した設定での一例では、小さなテキストファイルを読み取り、指定された情報を要約・抽出する作業で、ツール利用を挟んで、モデルとのやり取りが2回あり、作業全体に約3.8分かかりました。入力は順に2,948 tokenと3,412 tokenでした。一方、約6万tokenの測定は、59,999 tokenを1回入力して1回の応答を得たもので、回答開始前の入力処理に888.2秒かかりました。両者は測っている処理の範囲が異なります。エージェント用途では、生成速度だけでなく、後続の応答で扱う入力長と処理全体の時間も確認する必要があります。
実務では「長文を何回読み直すか」も判断材料になる
この規模のモデルをDGX Spark互換機(GB10)1台で試せる公開実装と、改良・最適化の実測結果があったからこそ、本検証では、処理パターンごとの待ち時間まで確認できました。本記事では、実務で使う際に確認すべきポイントを整理しました。
自社で確認するときは、次の三つの処理パターンを分けて測ると判断しやすくなります。
- 短い応答:生成処理の時間を測る。
- 長文の一回処理:入力から回答開始までの時間を測る。
- 反復エージェント処理:各回の入力長、応答回数、作業全体の時間を測る。
「1台で動くか」だけでなく、「何を、どの長さで、何回読み直すか」まで確認すると、今回の1台構成が、自社で想定する処理に合うかを検討する際の材料になります。
関連記事