GPUメモリ16GBのPCでローカルAIはどこまで使えるか:推論・API・通信・OpenCodeまで、今回の検証で見えた接続点
RTX 5070 Ti(GPUメモリ16GB)とPC本体のメモリ128GBを搭載した検証環境で、OpenCode(オープンソースのAIコーディングエージェント)から、Strataまたはllama.cppが提供するOpenAI互換APIへ接続する構成を試しました。このうちStrataを使った構成では、日本語文書の編集と形式確認まで進めました。
ローカルAIが応答しても、OpenCodeから安定して呼び出し続けられなければ、タスクは途中で止まります。Windows上のStrataのAPIを直接呼んだ試行では、正常な応答と途中の切断が混在しました。
今回の検証でどこまで動いたか
日本語文書の編集と形式確認まで進めた
OpenCodeは、ファイルの読み書きやコマンド実行などを組み合わせて作業を進められます。今回は、その中の一つの実務タスクとして、日本語文書を編集し、見出しなどの形式を確認しました。
Strata+Qwen3.8-Flash-Nextで行った文書編集では、「其他施策」という表現が1か所混ざりました。日本語なら「その他の施策」とする箇所です。見出しの形式確認では、こうした文章表現の違いまでは拾えません。
文書編集まで進んだ一方、Windows上でStrataのAPIを直接呼んだ試行では、正常に応答する場合と、途中で接続が切れる場合がありました。
検証環境:RTX 5070 Ti(GPUメモリ16GB)とPC本体のメモリ128GB
ハードウェアとソフトウェアの構成
今回の検証環境は、Windows 11 ProのデスクトップPCに、WSL2(Windows上でLinux環境を動かす仕組み)を組み合わせたものです。推論エンジン(モデルを実際に動かすソフトウェア)には、Strataとllama.cppを使いました。
| 項目 | 今回の検証環境 |
|---|---|
| GPU | RTX 5070 Ti(GPUメモリ16GB) |
| CPU | Intel Core i9-12900K |
| PC本体のメモリ | 128GB |
| ホストOS | Windows 11 Pro |
| Linux実行環境 | WSL2/Ubuntu 24.04.3 LTS |
| AIコーディングエージェント | OpenCode(WSL2上) |
表は今回使用した環境で、最低要件や推奨構成ではありません。128GBはPC本体の搭載量であり、OSが認識する量やWSL2で使える上限とは異なります。
今回のPCで試した推論エンジンとモデル構成は、次のとおりです。3構成とも同じ段階まで試したわけではなく、文章生成やOpenCodeでの作業まで進んだ範囲は構成ごとに異なります。
| 推論エンジン/API | 実行場所 | 試したモデル |
|---|---|---|
| StrataのOpenAI互換API | Windows上 | Qwen3.8-Flash-Next GSQ-RCO IQ3_S |
| llama.cppのOpenAI互換API | WSL2上 | Qwen3.8-27B UD-IQ4_XS(Unsloth) |
| llama.cppのOpenAI互換API | WSL2上 | ThinkingCap-Qwen3.8-27B IQ4_XS |
ThinkingCap版では、llama.cppの起動、モデルの読み込み、APIの待ち受けまで確認しました。この試行では文章生成やOpenCodeからの利用までは進めていません。
量子化は、モデル内部の数値を少ないビット数で表し、モデルファイルや重みが占めるメモリを小さくする方法です。今回、Strataでは3bit級のGSQ-RCO IQ3_S、llama.cppでは4bit級のUD-IQ4_XSとThinkingCap版IQ4_XSを使いました。いずれもRTX 5070 Ti(GPUメモリ16GB)を搭載した同じPCで試した構成です。
モデルの規模とGPUメモリ容量は別のもの
GPUメモリ16GBはGPU側の容量です。PC本体のメモリ128GBは、それとは別に搭載した容量です。GPUやCPUが計算を担い、モデルのデータをどこに置くかは推論エンジンと設定によって変わります。
ベースモデルのQwen3.8-Flash-Nextは、入力に応じて必要な計算部分を選んで使うMoE方式です。言語モデルの中核部分は125Bですが、文章の処理単位である1トークンの計算に使われる部分は約6Bです。Bは、モデル内部の数値(パラメーター)の数を10億単位で表します。ただし、約6BだけをGPUメモリへ載せればよいという意味ではありません。
一方、ベースモデルのQwen3.8-27Bは、MoEのように複数の計算部分から一部を選んで使う構造ではないdense型です。llama.cppでは、Qwen3.8-27BのUnsloth版UD-IQ4_XSと、同じ27Bをベースに追加学習したThinkingCap版IQ4_XSの両方を試しました。27Bという規模や4bit級という表記だけで、実行時のデータがすべてGPUメモリに収まるかは決まりません。
OpenCodeからローカルAIへ接続する構成
推論エンジンのAPIをOpenCodeから呼び出す
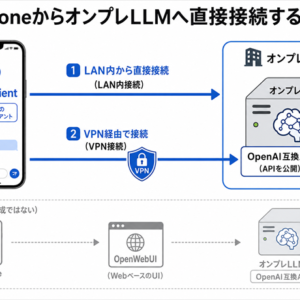
OpenAI互換APIは、OpenAIのAPIに合わせた形式で要求を受け付ける窓口です。OpenCodeがこのAPIへ要求を送り、Strataまたはllama.cppがモデルを動かして回答を生成します。要求の向きは、OpenCode → OpenAI互換API → 推論エンジン → モデルです。
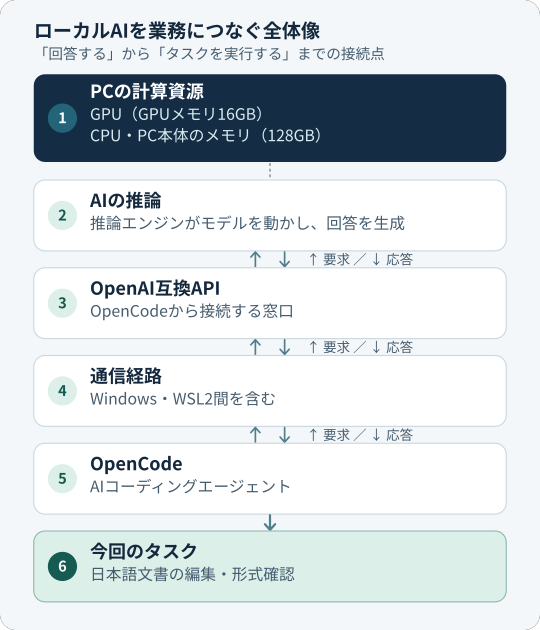
OpenCodeはモデルの応答を受けながら、文書を読み、編集し、形式を確かめる操作を進めます。モデル自体が応答できても、APIへの接続が途中で切れると、次の操作へ進めなくなります。
OpenCodeはWSL2上、StrataはWindows上で動かした
OpenCodeはWSL2上で、StrataはWindows上で動かしました。Strataを使うときは、WSL2上のOpenCodeから、Windows上のStrataが公開するAPIへ接続します。
一方、llama.cppはOpenCodeと同じWSL2側で動かしたため、OpenCodeからWSL2内のllama.cppのAPIへ接続します。Strataを使う経路はWindowsとWSL2の間をまたぎ、llama.cppを使う経路はWSL2内でつながります。
AIは応答しても、通信で止まることがある
Windows上のlocalhost接続で、応答と切断が混在した
Windows上でStrataのAPIを直接呼んだ試行では、モデルが正常な回答を生成する場合と、途中で接続が切れる場合がありました。症状が出たのは、同じWindows上でStrataのAPIへ接続するlocalhost接続です。localhostは、この場合は同じWindows PC自身へ接続するための宛先です。
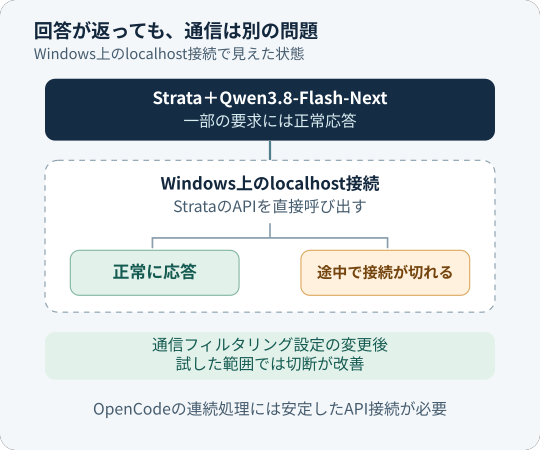
Windows側の通信フィルタリング設定を変更した後は、試した範囲で切断が改善しました。ただし、今回の試行だけで原因を一つに絞ることはできませんでした。
OpenCodeは、タスクを進めるためにAPIを繰り返し呼び出します。一度だけ応答が返るのではなく、処理を続けている間に接続が切れないことが必要です。
WSL2からStrataへは、モデル一覧を取得できた
Windows上のlocalhost接続とは別に、WSL2からWindows上のStrataへ接続する試行も行いました。接続先にはWindowsホストのアドレスを使い、Strataの待ち受け設定とWindows側の通信許可を調整した後、利用可能なモデル一覧を取得できました。文章生成やOpenCodeの連続処理までを、この同じ試行で行ったわけではありません。
Windows上のlocalhost接続と、WSL2からStrataへ向かう接続では、接続元と経路が異なります。今回、正常な応答と切断が混在したのは前者で、後者ではモデル一覧の取得まで確認しました。
長い文書では、入力できる量と内容の正確さを分ける
参照本文・補助資料・編集対象を組み合わせた長文文書編集テスト
長い社内規程や報告書を編集するときは、修正対象だけでなく、参照元の複数の箇所や補助資料もモデルへ渡す必要があります。必要な情報を揃えるほど、モデルが扱う入力は増えます。
今回の長文文書編集テストでは、事業の経過をまとめた長い参照本文、用語の定義や予算・実績の数値を照合する補助資料、修正対象の日本語文書を用意しました。参照本文と補助資料を読み合わせ、編集対象にある数値や説明を直すタスクです。
ただし、モデルが一度に扱える情報量には上限があります。入力だけでなく、会話履歴や出力なども含む量の上限に関わる設定を「コンテキスト長」と呼びます。この上限を意識して、128K級の長い入力を想定したテストを用意しました。128K級は約12万8千トークン規模を想定した呼び方で、実際に一度に投入した量を示す数値ではありません。
編集結果の作成と、長文全域の読解性能は分けて見る
このテストでは、編集後の日本語文書を作成できました。一方、「長文のどの位置にある情報まで正しく拾えたか」を位置別に採点するテストは行っていません。128K全域の読解性能を測ったベンチマークではなく、長い参照資料を使う文書編集を試したものです。
問題が起きたときの切り分け順
今回、Windows上のlocalhost接続ではモデルの応答と接続の継続が一致しませんでした。推論エンジンの起動からOpenCodeでのタスク実行までは、次の五つの段階に分かれます。
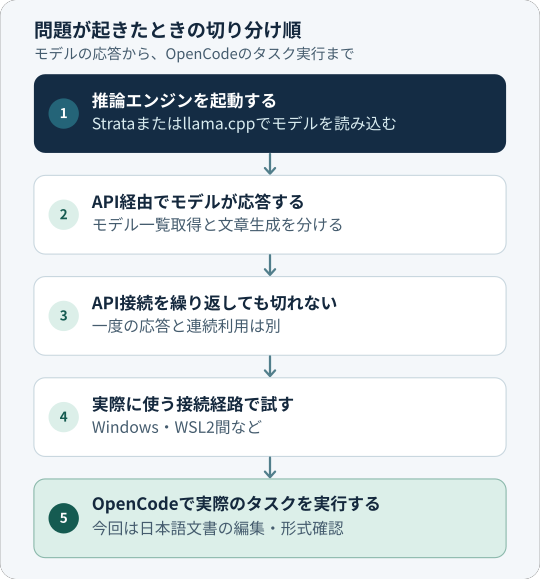
- 推論エンジンを起動する。 Strataやllama.cppがモデルを読み込み、入力を受け付けるかを確かめます。
- API経由でモデルが応答するかを試す。 OpenCodeを介さずに、API経由でモデルに文章を生成させます。モデル一覧の取得と、文章生成を分けて試します。
- API接続を繰り返しても切れないかを調べる。 同じ接続先へ要求を送り、一度の応答だけでなく、連続利用の途中で切断が起きないかを見ます。
- 実際に使う接続経路で試す。 StrataならWSL2からWindows上のStrataのAPIへ、llama.cppならWSL2内のllama.cppのAPIへ要求を送り、接続と文章生成を試します。
- OpenCodeで実際のタスクを実行する。 Strataを使った試行では、日本語文書を編集し、変更箇所と見出しなどの形式を確かめました。
Windows上のlocalhost接続では、モデルが応答する試行と、途中で通信が切れる試行がありました。OpenCodeを使った別の試行では文書編集と形式確認まで進んでおり、モデルの単発の応答だけではタスク全体の完了は決まりません。
まとめ:GPUだけでなく、接続経路まで見る
GPUメモリ16GBという仕様だけでは、今回のローカルAI環境は説明できません。モデルの置き方、PC本体のメモリ、推論エンジン、API、WindowsとWSL2の接続、OpenCodeまでが一続きの処理経路です。
今回のPCでは、RTX 5070 Ti(GPUメモリ16GB)を搭載した環境でStrata+Flash-Nextとllama.cpp+27B系の3構成を試しました。Strataを使った試行ではOpenCodeで日本語文書の編集と形式確認まで進んだ一方、Windows上のlocalhost接続では正常な応答と途中の切断が混在しました。モデルが応答しても、通信が途中で切れればOpenCodeの処理は続けられません。今回の3構成では、モデルを試す段階と、API・通信経路を通じてOpenCodeのタスクへ進む段階で、到達した範囲が異なりました。