自分の声を使ったローカルAI音声合成:RTX 5070 Ti (16GB) で追加学習から長文ナレーションまで検証
AI音声合成(TTS:Text-to-Speech)は、文章をAIで音声へ変換する技術です。この記事では、RTX 5070 Ti (16GB) を搭載したデスクトップPCのローカルAI環境で、GPT-SoVITSに自分の声のデータを追加学習し、原稿テキストから自分の声に合わせたWAV音声を生成する概念実証(PoC)を行いました。
今回の記事で扱う追加学習、音声合成、長文処理は、Pythonスクリプトとコマンドラインから実行しました。
今回のPoCでは、次の内容を検証しました。
- クラウド音声サービスではなく、ローカル環境で検証しました。
- 自分の声のデータを使って追加学習しました。
- 原稿テキストからWAV音声を生成しました。
- 短い文章だけでなく、長文を扱う運用まで検証しました。
以下では、一度音が出た段階から、実際の運用へ至るまでの過程をたどります。
ローカルAIで何ができたのか
まず、今回のPoCで何を確認できたのかを整理します。
| 確認した点 | 今回の結果 |
|---|---|
| ローカル環境でAI音声合成を実行できるか | RTX 5070 Ti (16GB) を搭載したPC環境で今回のPoCを実施 |
| 自分の声へ合わせられるか | 32発話・197.81秒(約3分18秒)の自分の声のデータを使って追加学習 |
| 長い原稿も扱えるか | 約1,000文字級の一括合成では文章の欠落を確認。原稿を20分割して個別に音声を生成 |
| 日常的に使える形まで持っていけるか | 原稿ファイルを指定し、分割計画の確認、音声の生成・結合、原稿全文の処理・出力確認までを手順化 |
| 機械確認だけで完結できるか | 機械確認だけでは完結させず、人による試聴も組み合わせた |
| 結果の適用範囲 | 今回のPC環境と検証条件で確認した結果として整理 |
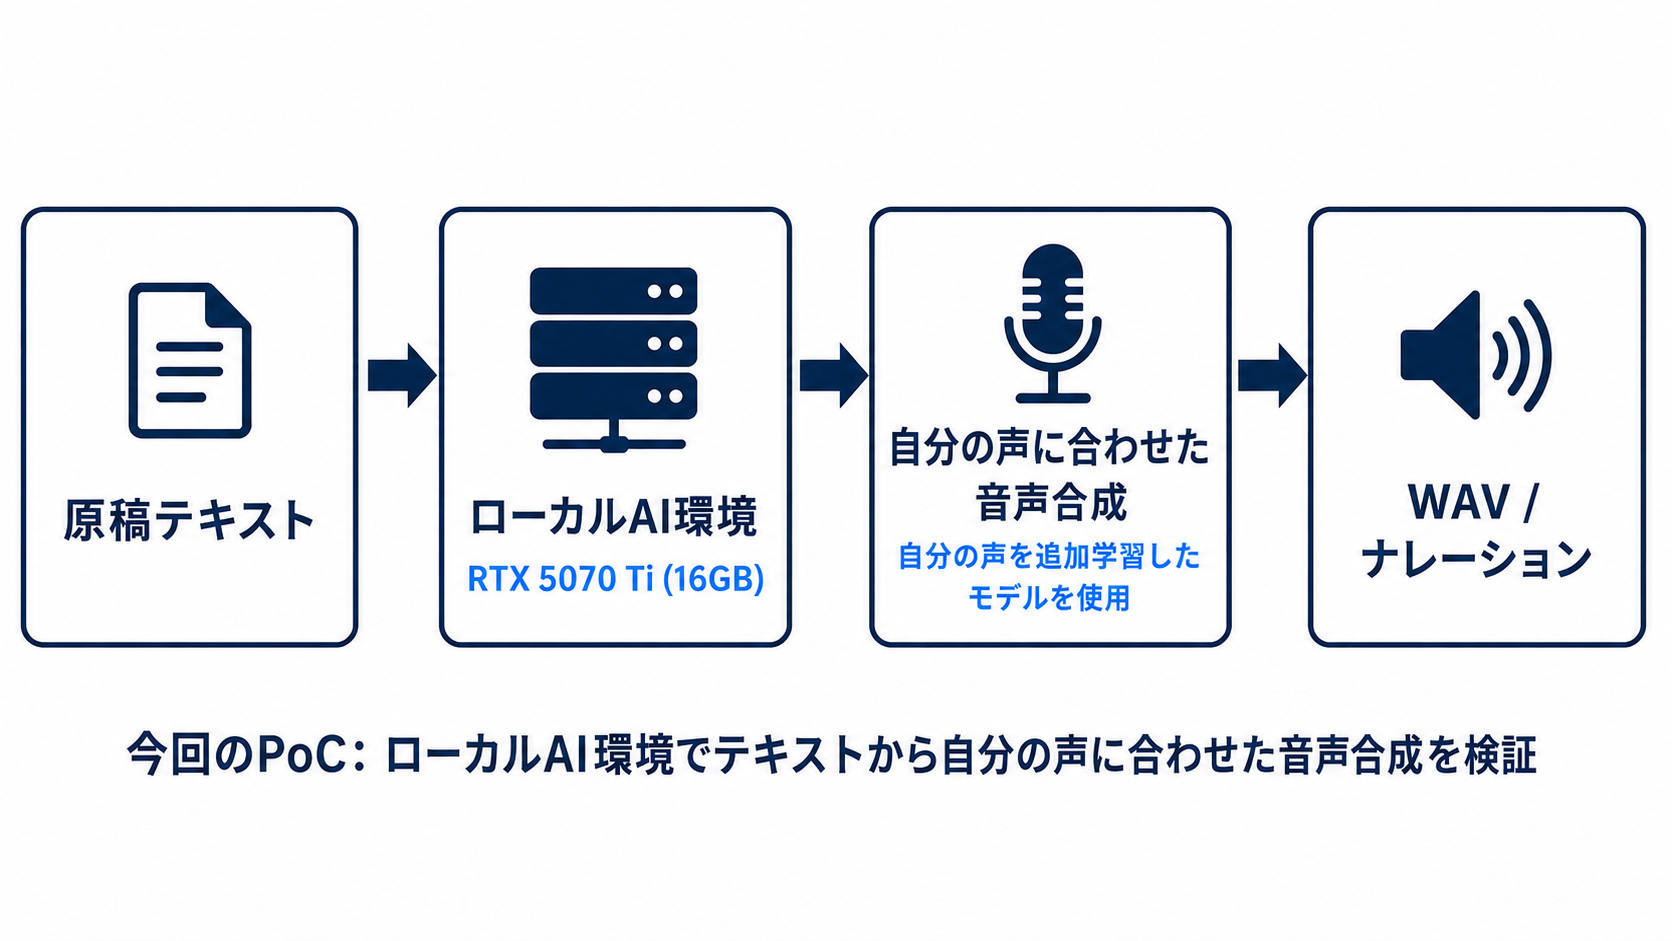
この構成でも、ローカル環境でAI音声合成を実行できることを確認しました。
| 項目 | 今回確認した値 |
|---|---|
| GPU | RTX 5070 Ti (16GB) |
| 実行環境 | Windows + WSL2 + Docker |
Windows上のWSL2とDockerからGPUを利用する実行環境を構築しました。
今回のPoCの流れ
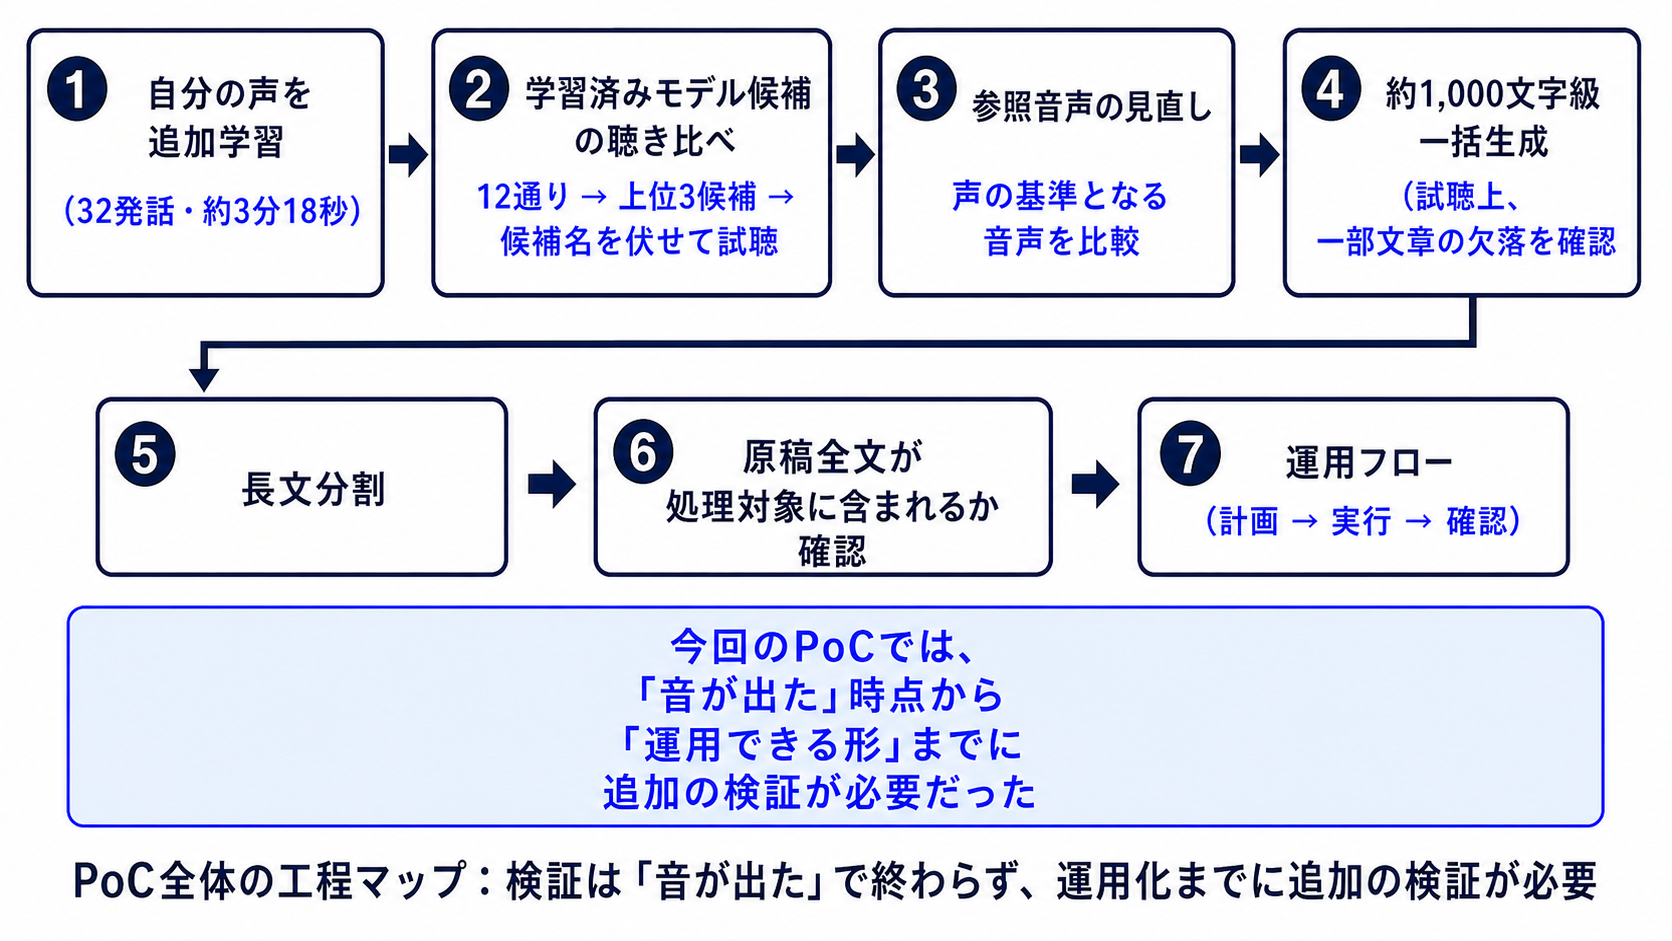
以下の手順でPoCを実施しました。
- 二つのモデルをそれぞれ追加学習し、学習済みモデル候補の組み合わせを12通り聴き比べました。
- 声の基準となる参照音声を比較し、最終的に6.420秒の発話中心版を採用しました。
- 短文の音声合成を確認し、再現性確認に用いる基準速度を1.0に固定しました。
- 長文の音声合成に対応する処理を導入し、約1,000文字級の原稿を20分割して、それぞれの音声を生成しました。
- 計画・実行・確認の流れと、中断時の途中再開手順を整えました。
音声のプライバシー保護のため、本文には音声サンプルを掲載しません。
約3分18秒・32発話の自分の声から学習
今回は32発話、合計197.81秒(約3分18秒)を学習用データとして使いました。必要な音声量は用途や収録条件によって変わるため、ここでは今回の検証条件として実測値を示します。
学習用音声の確認と修正
機械による初回確認は32件、人による初回確認でそのまま採用できたものは27件でした。区切り位置で音声が切れていた5件は、人の確認で不採用としました。この5件だけを分割し直し、音量処理、発話区間の切り詰め、無効サンプルを発生させることなく、人による再確認を通過しました。
最終的な採用結果は次のとおりです。
| 確認項目 | 結果 |
|---|---|
| 採用したWAVファイル | 32 |
| 採用した文字起こしファイル | 32 |
| 学習リストの行数 | 32 |
| 機械確認 | 32件すべて合格 |
| 人による確認 | 32件すべて合格 |
| 不採用/保留 | 0件/0件 |
| サンプルレート | 44,100 Hz |
| チャンネル数 | 1(モノラル) |
| 音声データの形式 | 16ビットPCM |
追加学習に使ったのは、採用された32件のWAV、32件の文字起こし、32行の学習リストだけです。
自分の声へ合わせるために何を学習したか
GPT-SoVITSは、文章から音声を合成する処理を一つのモデルだけで行うのではなく、GPT側とSoVITS側という二つのモデルを組み合わせて使います。GPT側は文章から音声を合成するための情報を作り、SoVITS側はその情報と参照音声をもとに実際の音声へ変換します。
今回の検証では、GPT-SoVITSのV2構成を使用し、SoVITS側とGPT側をそれぞれ追加学習しました。
追加学習の条件
| モデル | 何を確認したか | 今回の設定 |
|---|---|---|
| SoVITS側 | 学習回数 | 8エポック(学習データ全体を8回繰り返して学習) |
| SoVITS側 | バッチサイズ(1回の計算でまとめて処理する件数) | 8 |
| SoVITS側 | 計算精度 | FP16(学習時に16ビット精度を使う設定) |
| SoVITS側 | 比較用に保存したモデル候補 | 学習2・4・6・8回目の4候補 |
| GPT側 | 学習回数 | 15エポック |
| GPT側 | バッチサイズ(1回の計算でまとめて処理する件数) | 8 |
| GPT側 | 計算精度 | 16-mixed(16ビットを使った混合精度設定) |
| GPT側 | 比較用に保存したモデル候補 | 学習5・10・15回目の3候補 |
SoVITS側では、学習2回目、4回目、6回目、8回目の時点で保存した4つのモデル候補を比較対象にしました。GPT側では、学習5回目、10回目、15回目の時点で保存した3つのモデル候補を比較対象にしました。最終的に使う候補は学習指標だけで決めず、4候補 × 3候補、計12通りの合成音声を聴き比べて選びました。
「学習できた」だけでは使えない:候補を聴き比べる
追加学習が完了しても、その時点では複数の学習済みモデル候補が残ります。そこで、実際に音声を生成して聴き比べ、採用する組み合わせを決めました。
まず、SoVITS側4候補とGPT側3候補を組み合わせた計12通りを聴き比べ、上位3候補まで絞りました。
次に、どの学習条件の候補か分からないよう候補名を伏せ、上位3候補を改めて試聴しました。
その結果、SoVITS側では学習8回目の候補、GPT側では学習15回目の候補を最終的に採用しました。
これは、最後の学習時点だから自動的に選んだのではありません。学習指標だけで話し手との似ている度合いや自然さを判断せず、12通りを実際に聴き比べた結果として選びました。
基準となる音声を変えると生成結果が変わった
音声を合成する際は、声の基準となる参照音声を選ぶ必要があります。今回のPoCでは、この選び方によって生成結果が変わったため、参照音声を見直しました。
複数の参照音声候補を比較
複数の候補を聴き比べ、声質や背景ノイズを確認しました。声質が良い候補はあったものの、比較した候補には背景ノイズへの懸念もあったため、声質が良かったものを暫定候補とし、参照音声の見直しを続けました。
10.000秒版では極端に短い出力を確認
採用モデルの組み合わせ、生成設定、対象文をすべて同じにして比較しました。
| 参照音声 | 長さ | 確認結果 |
|---|---|---|
| 10.000秒版 | 10.000秒 |
3つの短文テストのうち2つが約0.58秒、約0.94秒で終了 |
| 6.420秒の発話中心版 | 6.420秒 |
同じ3つの短文を最後まで生成できる状態への回復を確認 |
6.420秒の発話中心版を同じ条件で比較
同じ参照音声候補から発話部分を中心にした6.420秒版を用意し、採用モデルの組み合わせ、生成設定、対象文を変えずに10.000秒版と比較しました。今回の比較では、6.420秒の発話中心版で、同じ3つの短文を最後まで生成できる状態への回復を確認しました。一方、この比較だけでは、参照音声を短くしたこと自体が回復要因だったとは切り分けられません。6.420秒という長さは、今回のPoCで比較・評価したうえで最終的に採用した条件として示します。
短文が読めても、長文では文章が抜けた
短い文章を生成できても、そのまま長文を安定して生成できるとは限りませんでした。
今回の約1,000文字級の一括合成では、人による試聴で一部文章の欠落を確認しました。そこで本PoCでは、モデルを追加学習し直すのではなく、原稿を分割して処理する方法へ切り替えました。欠落した正確な箇所やモデル内部の原因までは特定していません。
モデルを変えず、原稿を分割して長文に対応する
そこで、AIモデル本体は変えず、原稿を分割し、各部分の音声を生成・確認・結合する長文処理の仕組みを用意しました。
この仕組みは原稿を複数の単位に分け、分割した原稿ごとに音声を生成します。その後、原稿全文が処理対象に含まれていることを機械的に確認し、合成音声を順番どおりに結合します。処理記録、途中再開、生成後の確認も、この仕組みで管理します。
約1,000文字を20分割し、原稿全文の処理を確認
原稿を分割して生成するときは、原稿全文が処理対象に含まれているかを確認する工程が必要です。20分割した後も、原稿の順序が変わっていないこと、文字の欠落や重複がないこと、20の部分がすべて処理されたことを機械的に確認しました。
今回確認した原稿は、約1,000文字、6段落で、20分割して処理しました。
長文の音声合成を確認
| 話速設定 | 分割数 | 合成音声の長さ | 処理結果 |
|---|---|---|---|
| 基準となる話速1.0 | 20 |
228.400秒 |
20分割すべてを処理 |
| 利用時の話速1.20 | 20 |
192.440秒 |
20分割すべてを処理 |
重要:機械的に確認したのは、分割後も原稿の順序が保たれ、文字の欠落・重複なく20分割すべてが処理されたことです。発音や自然さ、話者との似方、音質は文字列の確認だけでは分からないため、生成した音声を別途、人が試聴して確認しました。
実際の利用は「原稿ファイル→音声ファイル」
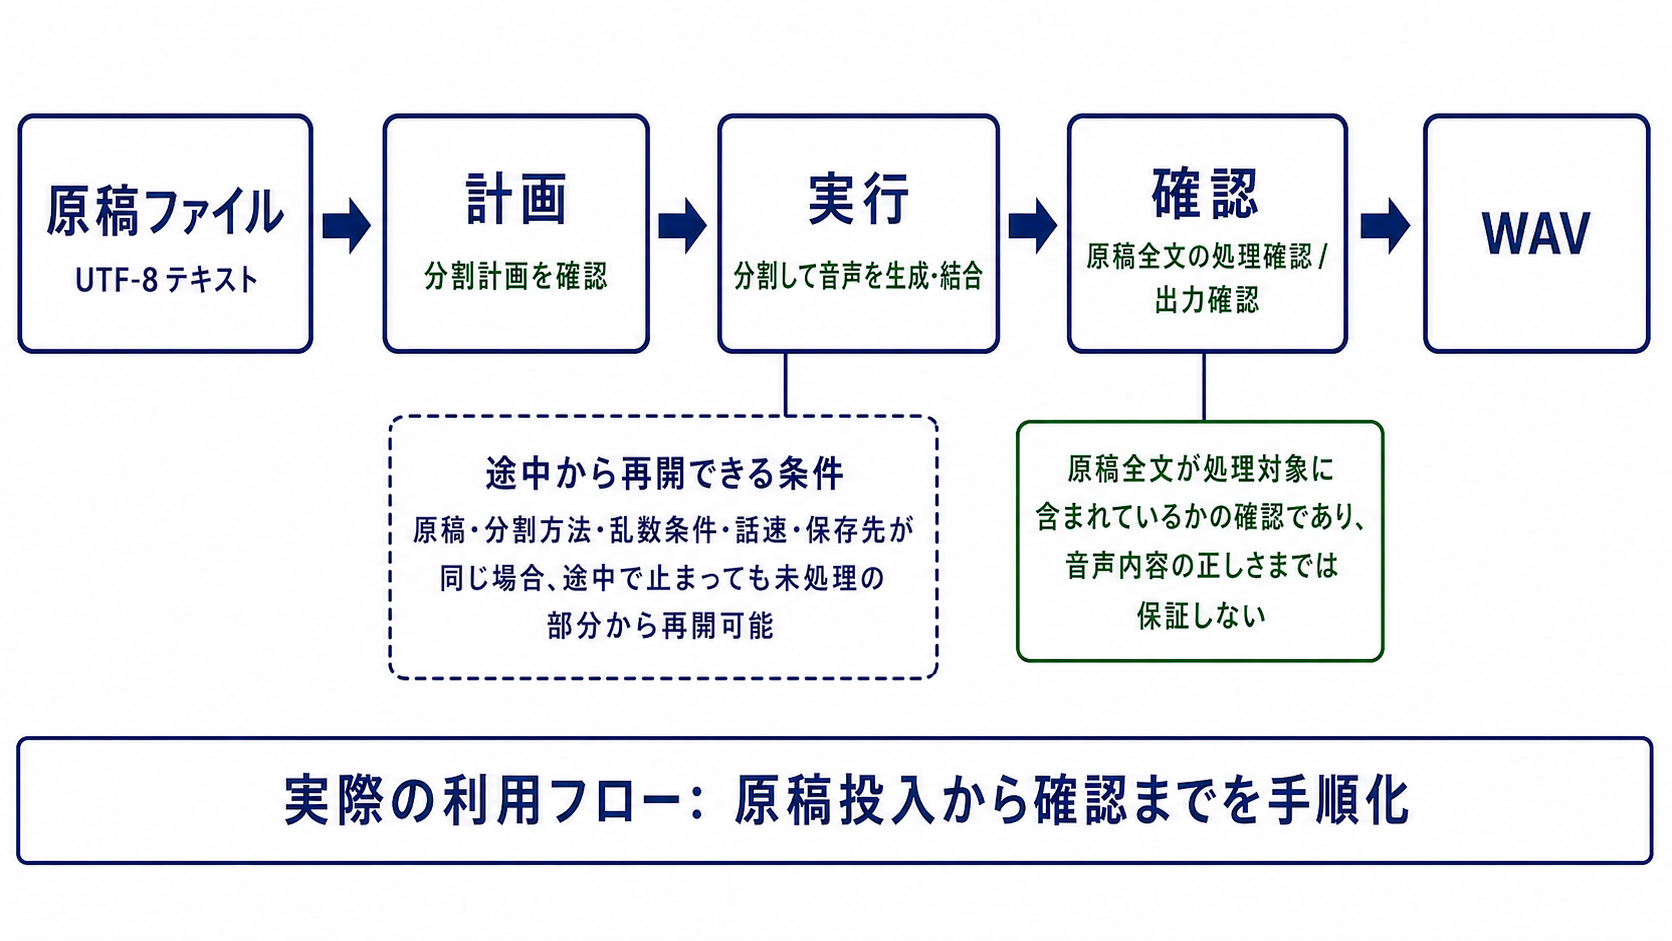
実際に使うときは、UTF-8の原稿ファイルを用意し、まず分割計画を確認します。次に原稿を分割して音声を生成・結合し、最後に原稿全文の処理と出力を確認してWAVファイルを得ます。
計画・実行・確認の流れ
計画では分割計画を確認します。実行では原稿を分割して音声を生成・結合します。確認では原稿全文の処理と出力を確認します。
途中で止まった場合も再開できる
同じ原稿、同じ分割方法、同じ乱数条件、同じ話速、同じ保存先であれば、途中で処理が止まっても、未処理部分から再開できます。条件が変わった場合は、同じ処理の続きとしては扱いません。
話速は用途に合わせて調整
- 再現性確認に用いた基準速度は
1.0です。指定を省略した場合も1.0になります。 - 今回の利用時には、人による試聴で快適だった設定として
1.20を使用しました。
GPUを使う別の処理とは同時に動かさない
今回のデスクトップPCでは、画像生成などGPU負荷の高い処理と音声合成を同時に動かさず、GPUメモリを大きく使う別処理が終わってから音声合成を始めました。今回の検証では、この運用で処理を分けています。
今回のPoCから見えた実用上のポイント
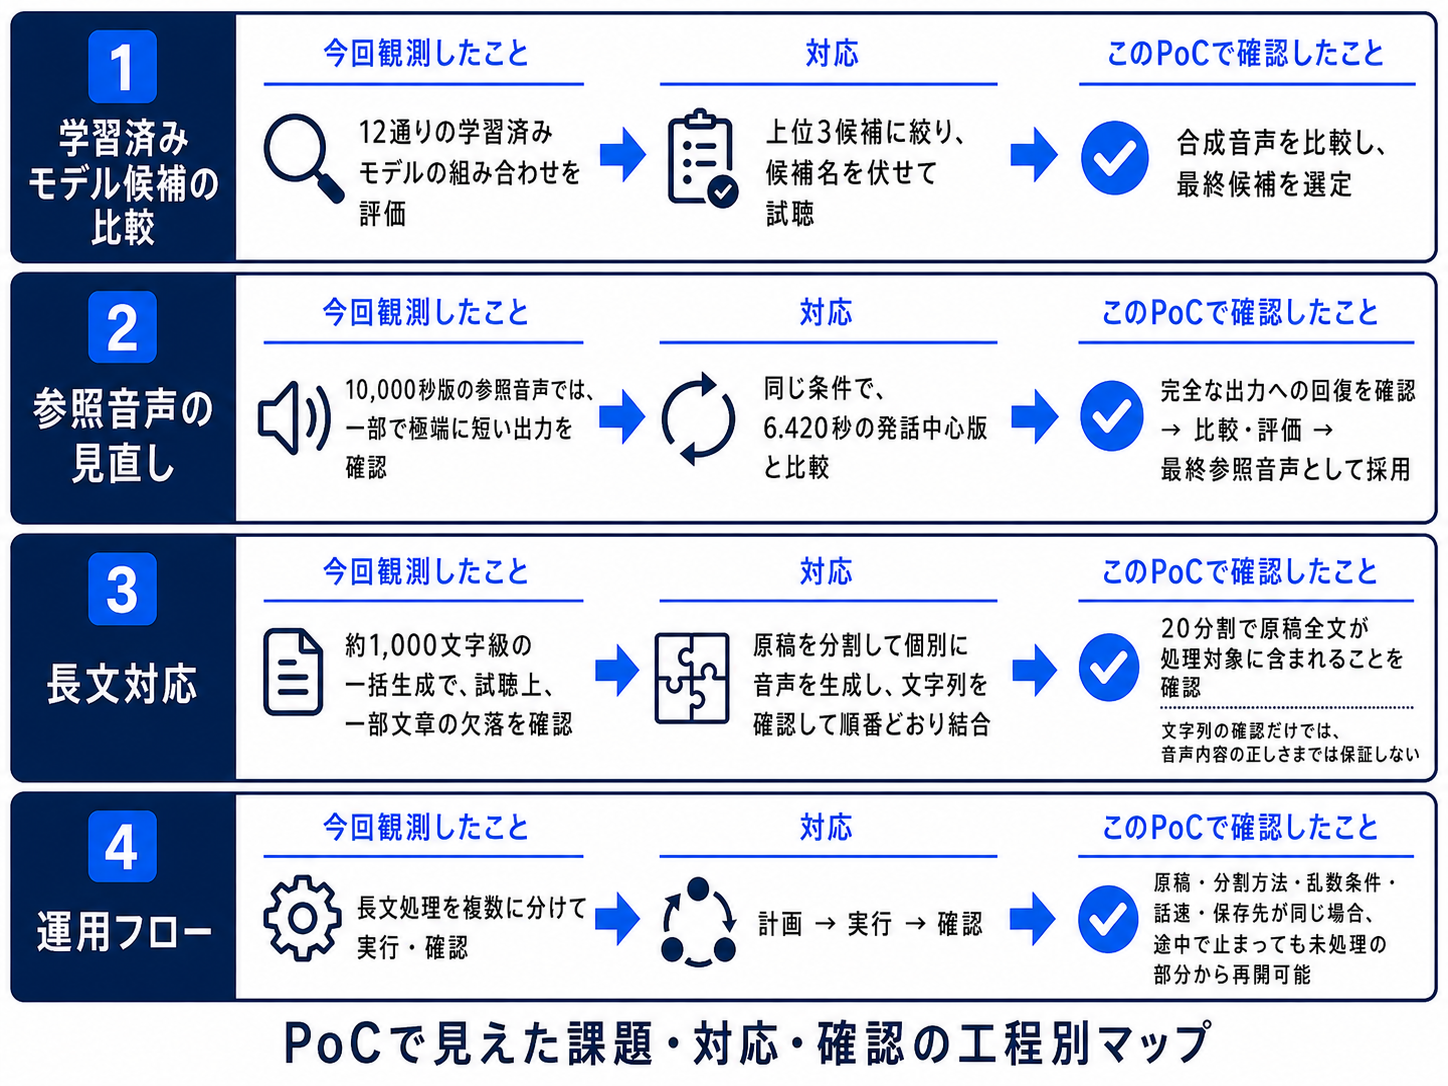
今回のPoCで最も重要だったのは、AIから一度音が出ることと、実際に使える形で音声を生成できることは別だと分かった点です。追加学習だけで完了とはせず、候補の聴き比べ、参照音声の見直し、長文対応、生成後の確認まで進めました。
学習済みモデル候補は、実際の音声で聴き比べた
学習の最後に保存された候補をそのまま採用せず、SoVITS側とGPT側の組み合わせを12通り比較しました。まず上位3候補へ絞り、次に候補名を伏せて試聴した結果、SoVITS側では学習8回目、GPT側では学習15回目の候補を選びました。学習指標だけではなく、合成音声を人が確認する工程が必要でした。
参照音声も、同じ条件で比較してから決めた
参照音声の選び方でも、今回の生成結果は変わりました。10.000秒版では、3つの短文テストのうち2つが約0.58秒、約0.94秒で終わる極端に短い出力になりました。一方、採用モデルの組み合わせ、生成設定、対象文を変えずに比較した6.420秒の発話中心版では、同じ3つの短文を最後まで生成できる状態への回復を確認しました。その比較・評価を終えた後に、6.420秒版を最終的な参照音声として採用しました。今回の比較だけでは、参照音声を短くしたこと自体が回復要因だったとは切り分けられません。
長文は、分割・確認・途中再開まで含めて扱った
今回の約1,000文字級の一括合成では、試聴上、一部文章の欠落がありました。そこで原稿を20分割して個別に音声を生成し、原稿全文が処理対象に含まれていることを機械的に確認しました。文字列上すべて処理されていることと、実際の音声内容が正しいことは別の確認です。発音や自然さ、話者との似方、音質は、人が合成音声を試聴して確認しました。
運用は計画、実行、確認の3段階に整理しました。原稿、分割方法、乱数条件、話速、保存先が同じ場合は、中断後も未処理部分から再開できます。
音声データを外部サービスへ送らず、ローカル環境で処理した
今回のPoCは、クラウド音声サービスではなく、RTX 5070 Ti (16GB) を搭載したデスクトップPC上で実施しました。自分の声の学習用データを外部の音声サービスへ送らず、追加学習から長文の音声合成までをローカル環境で処理しました。
検証条件:本記事で示す結果は、今回のPC環境、学習用データ、設定で確認したものです。環境や入力データ、設定が変われば、生成結果も変わり得ます。
成功した手順だけでなく、詰まった箇所も記録した
今回のPoCでは、採用した手順だけでなく、学習済みモデル候補の選び方、参照音声の10.000秒版で起きた極端に短い出力、約1,000文字級の一括合成で確認した文章欠落も記録しました。成功と失敗の両方を残すことで、次の検証で確認すべき点が明確になります。
まとめ
RTX 5070 Ti (16GB) を搭載したデスクトップPCのローカルAI環境で、自分の声の追加学習から長文の音声合成までを検証しました。その過程では、学習済みモデル候補を実際に聴き比べ、参照音声を見直し、長文を分割して原稿全文の処理を確認しました。実際の運用には、分割・確認・途中再開まで含めた手順が必要でした。
今回の結果は、RTX 5070 Ti (16GB) を搭載したPC環境と、今回使用した学習用データ・設定に基づくものです。一度音が出た後に何を確認し、どのように実際の利用手順へつなげたかを、ローカルAI音声合成の一事例として整理しました。
関連記事